2026.09.08
双 DGX Spark 上的 vLLM 推理:统一内存、并发吞吐与推测解码
基于历史部署与基准记录,分析双 DGX Spark 的启动内存约束、配置调整、单流与并发性能,以及推测解码的负载依赖性。
双 DGX Spark 部署利用两台设备的计算与内存资源运行 Qwen3.8-Flash-Next。部署记录涉及两个相互关联的问题:模型能否在共享内存约束下完成启动,以及启动后的服务能提供多大的推理吞吐。初始配置能够完成请求,首轮八路并发测试的聚合吞吐为 36.7 tok/s;部分配置切换则导致两台设备同时失去响应,需要现场重启。
截至 2026 年 9 月 8 日,调整后的配置完成了启动和短输出测试。在八个并发请求、温度 0.7、每请求输出上限 200 token 的条件下,最终回测的聚合吞吐为 91.6 tok/s。同一配置下的四任务测试中,中文短文、Python 代码和 JSON 生成的单请求解码速度分别为 26.9、40.5 和 48.3 tok/s。这些跨任务数字用于观察负载差异,不能拼接为配置调整前后的提速结果。
下文依据 2026 年 9 月 3 日至 8 日留存的工具输出与基准脚本,分析统一内存的容量约束、启动峰值、配置调整前后的性能,以及推测解码的负载依赖性。所有实验结果均对应历史配置;文章整理与发布期间未重新运行远端推理服务。
统一内存架构与双机容量约束
DGX Spark 的 CPU 和 GPU 共用物理内存。官方规格为 128 GB 统一内存、273 GB/s 内存带宽;两台机器可以通过 ConnectX-7 网络互连。模型权重、推理缓存、文件页缓存和普通进程共享同一物理内存池。CPU 侧内存占用增加时,GPU 可分配的空间也随之减少。NVIDIA 架构说明
所用量化检查点的社区张量统计约为 125.87 GiB。部署采用两机张量并行,将可分片的权重分配给两个推理进程,同时保留需要复制的参数和运行状态。双机增加了可使用的总内存,同时需要跨节点同步。任一节点无法继续计算,都可能阻塞整个请求。检查点分析
模型包含一张大型词组嵌入表,用于根据相邻 token 查询额外表示,部署代码称为 PLE。原方案沿用面向单机的内存映射实现,由 CPU 从映射表中提取数据,再传入计算路径。内存映射减少了常驻分配,代价是在执行过程中增加 CPU 取数与数据传输。
双机环境下,镜像原生实现已支持按词表切分 PLE,每台常驻约一半嵌入表。采用常驻分片前,需要确认该路径能够替代原有取数方式,并为系统进程和启动期间的临时分配保留内存余量。图 1 展示了相关内存组成。
最终配置使用混合精度(hybrid)检查点。模型加载日志报告的占用为 63.71 GiB;降低批次 token 上限后,启动输出报告的缓存容量为 1,791,741 token。两项指标分别描述加载内存与缓存预算,单位和含义不同。缓存容量也不等同于长上下文任务的验证结果。加载记录、缓存记录
计算环境配置与跨节点通信验证
9 月 3 日的初始检查表明,两台 Spark 已建立网络连接,原有两个推理服务处于停止状态。环境准备包括工具链检查、设备验证和基于密钥的管理连接配置。CUDA Toolkit 已安装,nvcc 未被发现的原因是其目录不在默认 PATH。通过完整路径编译并运行小型 CUDA kernel 后,两台设备均返回 cuda-ok,确认现有工具链可用。初始验证输出
计算环境一致性检查发现,原有容器的 PyTorch 版本不同,外部软件源的可达性也存在差异。ARM 平台的部分 wheel 仅支持 CPU,不能用于 GPU 推理。后续选用带 CUDA 的发行包,在一个节点下载后通过直连网络分发,并通过实际 GPU 运算验证安装结果。
网络验证进一步采用两机 all-reduce 测试,检查各进程参与求和后是否均收到预期结果,并按消息大小记录带宽。修改 MTU 前后,两轮求和正确性检查均通过;1 GiB 消息的报告带宽从 22.76 提高至 23.95 GB/s。这一结果仅描述通信微基准的变化,不能直接换算为模型推理的提速比例。通信对照输出
接口 MTU 从 1500 调整为 9000 后,端到端大包不分片检查通过,相关设置写入网络配置以避免重启后回退。上述检查确认了双机执行 GPU 集合通信的基本条件。
第一版 vLLM 部署随后完成了端到端请求。9 月 3 日有一条旧配置记录,输入为 136,068 token,生成 80 token,总耗时 152.3 秒;另外检查了 API 鉴权,不带密钥或使用错误密钥返回 401,正确密钥返回 200。这条请求和鉴权检查确认了旧配置在相应时段的行为。完整 1M 上下文及当前服务状态不在其验证范围内。请求与鉴权记录
基础部署验证完成后,后续实验转向推理引擎适配与吞吐优化。
SGLang 构建适配与引擎选择
SGLang 是本次评估的另一条推理引擎路线。这次构建为 GB10 指定了 sm_121a 目标,适配工作涉及 CUDA 内核构建范围、编译并发控制,以及内核包与 Python 依赖的版本匹配。
早期构建同时覆盖多个 GPU 架构,并使用较高任务并发。会话记录显示,一次 16 并发构建导致设备失去响应。后续将构建范围限制为本机架构,关闭无关目标,并采用串行构建控制内存峰值。目标数量从 141 减至 61,最终完成内核 wheel 打包,并在 SGLang 0.5.19 上通过 Qwen3-0.6B 冒烟测试。
内核打包与小模型测试确认了基础运行环境可用。目标大模型还需要专门的实现与正确性验证:当时 Qwen3.8-Flash-Next 的实现仍在独立 PR 中,尚未并入主干;相关讨论也涉及注意力计算和多轮执行的正确性。小模型测试未覆盖目标模型的这些专用执行路径。目标模型支持 PR
后续吞吐实验集中于已能运行目标模型的 vLLM。SGLang 路线完成了基础构建适配,目标模型仍需单独验证。现有记录未包含两种引擎运行该模型的同条件性能对照。
启动阶段的内存峰值与故障处理
vLLM 配置实验首先尝试启用 PLE 常驻,并提高推理进程可使用的内存比例。权重加载完成后仍有可用内存,但服务在后续初始化过程中失败。仅用 PLE 容量解释故障,无法区分启动阶段的其他开销。排查因此进一步检查编译过程中的临时分配。
相关实验包含两类编译过程:SGLang 的 CUDA 扩展构建,以及 vLLM 服务启动时的 torch.compile 相关处理。两者均可能产生高于稳定运行状态的内存峰值。判断启动余量时,需要检查整个初始化过程,不能只依据权重加载完成时的内存占用。
为定位失去响应前的内存变化,宿主机增加了持续采样,记录可用内存、页缓存、swap,以及常驻内存(RSS)占用最大的进程。图 2 展示一次失败启动中留存的离散采样点,未对缺失区间插值。
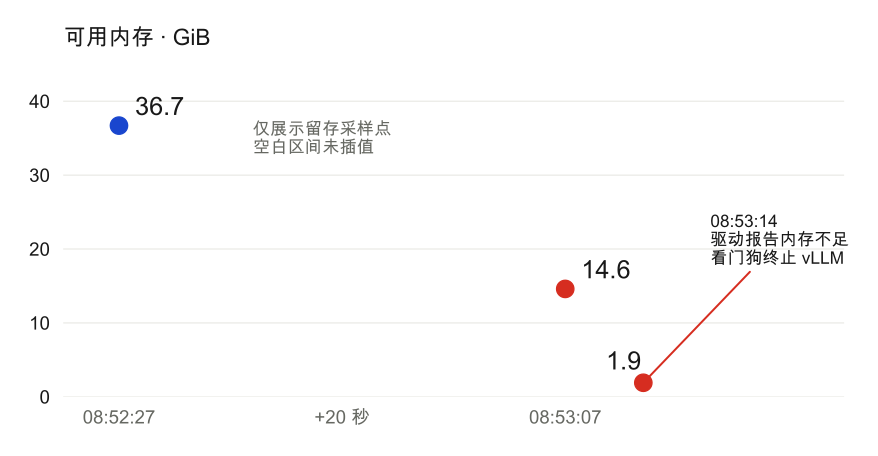
同一组输出包含驱动的 NV_ERR_NO_MEMORY,以及可用内存低于阈值后终止 vLLM 的看门狗日志。该轮 swap 记录为零,关闭交换空间并未避免这次内存耗尽。现有证据不足以将全部失联事件归因于 swap 抖动或活锁。
后续配置在启动脚本中设置 CMODE=0,对应当时 vLLM 的编译模式 0,以关闭该启动编译路径;同时保留仅用于解码阶段的 CUDA graph。该配置完成了后续初始化验证。
调整后,健康检查返回 200,日志记录了 CUDA graph 捕获完成,服务恢复至可执行性能测试的状态。启动与基准输出
故障处理后,运行流程增加了由 systemd 管理的看门狗与持久日志;实验前核对交换空间和系统余量,并限制编译任务与推理服务的资源竞争。看门狗依赖宿主机调度,无法保证恢复已经阻塞的驱动调用。启动前检查资源余量、启动期间监测内存峰值,仍然不可省略。
环境配置还触发过容器设备访问异常。安装 systemd 服务后,运行中的 GPU 容器报告 Failed to initialize NVML: Unknown Error。NVIDIA 文档说明,在通过旧式 runtime hook 注入 GPU、并由 systemd 管理容器 cgroup 的配置下,daemon-reload 可能使容器失去 GPU 访问权限。此类故障应先检查容器设备访问,必要时重建容器,避免将环境异常误判为模型执行错误。NVIDIA 故障说明
配置调整前后的并发吞吐与单流性能
启动问题处理后,双机方案采用以下配置:PLE 按词表分片常驻、解码使用 CUDA graph、启用专家并行、采用 FP8 推理缓存,并由预测头每轮提出三个候选 token。后者利用多 token 预测(multi-token prediction,MTP)能力进行推测解码,其收益取决于候选接受情况与额外执行成本。
本轮迁移同时调整了上下文长度和内存比例,并将同时调度的请求上限从 4 改为 8。这些条件同时变化,因此对照结果只能描述整套部署配置的差异,不能分离出每个参数的独立收益。
八路并发测试同时发送八个请求,温度设为 0.7,每个请求最多生成 200 token,以总生成量除以整组请求的墙钟时间。原配置生成 1,600 token 耗时约 43.5 秒,新配置约为 17.3 秒,聚合吞吐从 36.7 提高至 92.7 tok/s。最终 hybrid 配置的回测值为 91.6 tok/s。图 3 分别展示并发与单流结果。
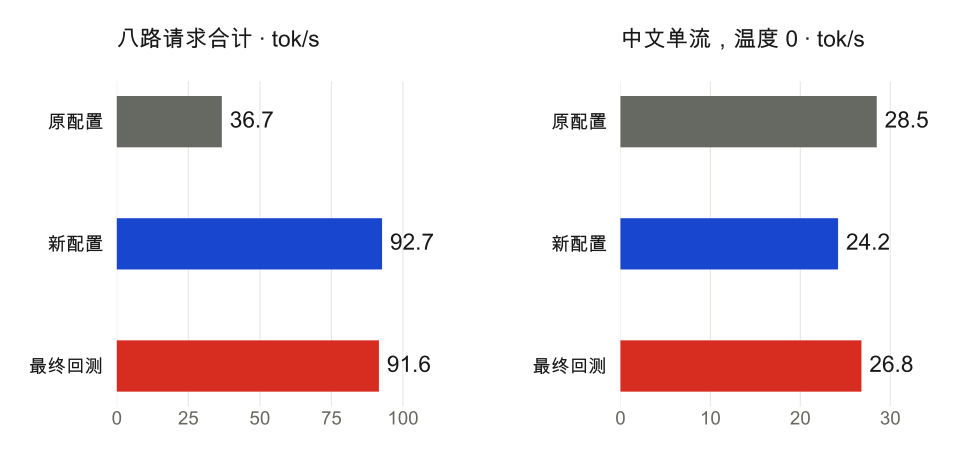
单流性能未呈现相同幅度的改善。温度 0 下,原配置、新配置与最终回测分别为 28.5、24.2 和 26.8 tok/s;温度 0.7 下,三者分别为 19.4、23.8 和 24.1 tok/s。所测八路并发场景的改善幅度高于单流场景,单请求结果还随采样条件变化。采样温度用于调整候选 token 的概率分布;本次温度 0 对应贪心选择,温度 0.7 则允许随机采样。因此,对照时需要固定温度,避免将生成路径变化误判为执行性能变化。
最终八路并发的聚合吞吐为 91.6 tok/s,按请求数平均约为每路 11.4 tok/s。提高系统总处理能力与缩短单请求生成时间属于不同优化目标,可能对应不同配置。
关闭 MTP 的一次八路测试达到 98.3 tok/s,高于最终配置;该轮温度 0 的中文单流为 23.7 tok/s。这次反例说明,MTP=3 不能直接作为所有负载的默认最优选择;单次扫描也不足以确定并发场景的最优配置。
执行路径对照与混合精度适配
服务能够完成连续测试后,单流性能排查进一步覆盖分布式执行器、通信、内存带宽、预测头加载方式和量化配置。下表汇总各项对照及其结论范围。
| 对照项目 | 观测结果 | 解释与适用范围 |
|---|---|---|
| 原生多进程执行器与 Ray 对照 | 中文贪心单流 20.6 tok/s,八路聚合 89.9;恢复 Ray 后分别为 23.3、93.5 | 本轮切换未产生性能收益,后续保留 Ray;结论限于所测配置 |
| 两机小消息 all-reduce | 8 B–8 KiB 的两 rank 测试约 22–27 μs,报告错误数为零 | 基础通信链路能够正常完成测试;真实推理里的等待仍需时间线分析 |
| 单机内存与窄矩阵运算 | copy/sum/add 约 225/256/220 GB/s;窄矩阵测试 M=1 与 M=4 为 167/266 GB/s | 简单流式带宽接近规格,但小形状矩阵不能直接套用峰值带宽 |
| MTP 权重与加载路径 | 原检查点的 MTP 权重为 BF16,量化配置把它排除在转换范围外 | “未量化”日志本身不构成加载错误的证据 |
| 换用 NVIDIA 检查点 | 一轮混合测试窗口的草稿接受率 33.3%,原检查点对应窗口 34.3% | 换检查点没有解释当时预期的巨大差距;继续控制任务与采样条件 |
| 批次 token 上限从 8192 降至 2048 | 四任务的折算步时均值约 81.0 → 79.3 ms | 差异较小,缺少重复轮次与波动范围,无法确认收益的稳定性 |
通信和带宽测试分别留有原始输出与算子微基准。这些微基准分别检验通信与算子执行表现,尚不能分解模型推理的完整耗时。例如,106 次通信乘以约 25 μs 仅构成数量级估算,未测量真实执行中的重叠、排队与同步等待。
混合精度适配将部分 BF16 稠密层转换为分块 FP8,与原有 NVFP4 专家权重共同组成 hybrid 检查点。转换后,加载日志中的模型占用下降,并完成了后续性能实验;量化对输出质量的影响未在本轮短输出测试中评估。
分块尺寸约束必须在并行切分之后仍然成立。一个共享专家的中间维度为 640,双机切分后每份为 320,不能被 128 整除。因此,单机适用的 128×128 分块转换在该层未通过校验,后续将其从转换目标中排除。
加载器补丁还需要确认实际执行的代码分支。原补丁只修改 ModelOptNvFp4Config;NVIDIA 检查点的量化元数据却把加载器导向 ModelOptMixedPrecisionConfig。日志打印“patch applied”,并不代表正在使用的类被修改。补丁扩展到两种类后,再检查 blockwise-fp8 layers detected 和模型加载完成,才确认转换后的权重进入了预期路径。
检查点转换还涉及文件独立性。硬链接副本与源文件共享同一底层文件。准备脚本用 cp -al 创建检查点目录,转换器又会原地重写索引 JSON。如果直接打开副本写入,源目录中的索引也会改变。修正办法是在副本目录生成新文件,再替换副本入口,并检查索引的链接数为 1、inode 与源文件不同。已有记录支持“发现并修正了破坏源索引的风险”,没有证据说明整套源权重已经被损坏。
上述修改属于转换和加载过程的修正。复用方案时,需要检查分片后的维度、实际使用的加载器,以及源文件与转换结果是否相互独立。
任务内容对推测解码收益的影响
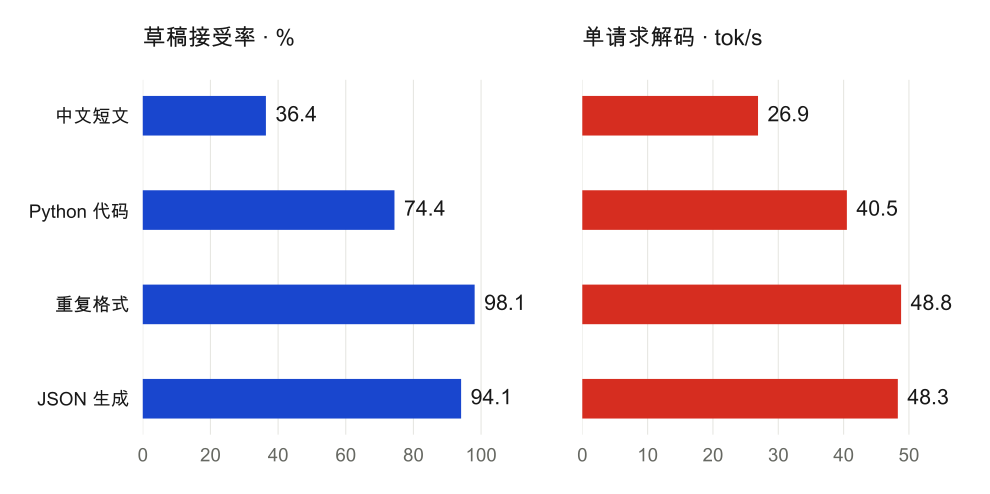
检查点切换未能解释此前的低接受率,因此进一步对照不同任务。在同一配置上,依次生成中文短文、Python 缓存类、重复格式文本和 JSON 数组。图 4 展示最终一轮结果。
普通自回归生成逐步产生下一个 token。推测解码先由预测头提出多个候选,再由目标模型验证;候选与目标模型生成路径的匹配程度越高,一轮验证可保留的 token 就越多。图 5 展示该过程的示意序列。
四任务测试中,中文短文平均每轮接受约 1.09 个草稿 token,Python 为 2.23,JSON 为 2.82。加上目标模型确定的一个 token,每轮输出量分别约为 2.09、3.23 和 3.82。如果每轮耗时接近,单轮保留的 token 越多,解码速度就越高。
结构较固定的输出可能更容易与预测头的候选匹配,这与本轮接受率的变化一致。但每类任务仅包含一个提示词,结果不足以推广为语言或任务类别的普遍规律。检查点、采样方式、上下文和具体内容均可能改变候选的匹配程度。
同一检查点在其他任务上出现了较高接受率,因此低接受率不能仅归因于检查点本身。社区报告可用于形成对照假设,但部署间的性能比较仍需对齐提示词、生成长度和计时口径。
输出长度限制也影响任务完成情况。JSON 提示词要求 25 条完整记录,重复格式提示词要求 60 行,但请求上限为 300 token。本轮测试衡量生成速度,未验证完整 JSON 的可解析性或代码的可执行性。任务完成率与生成质量仍需独立评估。
四个提示词与计时口径
每个任务先预热一次。速度使用后续三次请求的中位数;脚本另发一次请求读取首字延迟和输出 token 数,所以接受率的采样窗口覆盖四次请求。
- 中文短文:
请写一段 400 字的短文,主题:分布式推理系统里的 KV cache 管理。 - Python:
Write a complete Python class ThreadSafeLRUCache with get/put/delete, an OrderedDict backing store, a threading.RLock, TTL support, and full type hints. Include docstrings. - 重复格式:
List the numbers 1 through 60. For each, write one line in exactly this format: 'Item N: value=N, squared=N*N, status=active'. - JSON:
Generate a JSON array of 25 user records. Each object has fields: id (int), name (string), email (string), age (int), city (string), active (bool). Output only valid JSON.
四任务测试均为温度 0、关闭 thinking、输出上限 300 token。脚本以 (completion_tokens − 1) / (最后一个非空内容块时间 − 第一个非空内容块时间) 估算解码速度。流式内容块可能含多个 token,所以这是客户端观察值;首字延迟另计,不能把二者混为端到端吞吐。
另一个 bench-vllm.sh 脚本在整组实验末尾读取累计接受计数,覆盖多个温度和并发条件。它的总体接受率不能配给某一行单流速度。
解码步时估算与待验证的开销来源
解码速度可以分解为单轮输出量与单轮耗时。在固定提出三个草稿、每轮另确定一个 token 的近似下,两者满足以下关系:
代入最终四任务的数据,折算步时分别约为 77.7、79.8、80.7 和 79.1 ms,均值约为 79.3 ms。折算结果较为接近,与图 4 中速度差异主要关联单轮输出量的解释一致。
上述步时由汇总统计量相除得到,速度与接受率的采样请求并不完全一致。结果适合用于数量级分析,不能替代服务端逐步计时,也不能据此认定每轮耗时恒定。
原始分析曾利用 MTP=0 与 MTP=3 两个点拟合“固定开销 + 每次前向开销”,将约 21 ms 归入草稿步骤。该归因仍属于待验证假设:两种设置会改变计算量、算子形状和执行路径,仅凭总耗时无法识别 Python 元数据处理的独立占比。
运行日志提供了一条具体的开销线索:该模型的稀疏注意力后端不支持融合的多步草稿解码,执行时会在草稿步之间重建注意力元数据。源码摘录显示,快速路径的启用取决于后端的 supports_draft_decode_metadata_update 能力。历史源码与分支记录
日志确认了回退路径被执行,但未给出该路径的独立耗时。因此,21 ms 的可消除时间和 55 tok/s 的优化后速度仍是未经验证的推算。后续需分别测量元数据构建、GPU 执行和同步等待,再评估原地更新路径,并验证多轮、长上下文以及草稿拒绝后的状态正确性。
字节量与带宽的比值同样属于简化估算。9.2 GiB 相当于约 9.88 GB,以 250 GB/s 计算约为 39.5 ms;混用 GiB 与 GB 会低估结果。实际执行还受缓存复用和小矩阵带宽利用率影响,因此,79 ms 与该理论值之差不能全部归入 CPU 开销。
部署结果、测量局限与后续验证
截至最后一轮留存记录,服务采用 RadixArk hybrid 检查点,两机张量并行、专家并行、PLE 常驻、FP8 缓存和 MTP=3;上下文上限 262,144,内存比例 0.70,批次 token 上限 2,048,编译模式 0,CUDA graph 只捕获解码。它完成了本文的短输出与八路并发测试。这组参数可作为后续对照的工作配置,现有测试未证明其在所有任务上最优。
定位性能限制,需要将总体速度分解到具体阶段和测量条件。启动故障需要分别观察加载、编译、缓存分配和图捕获阶段的内存;吞吐分析需要区分单流与并发;MTP 收益则需要联合考察单轮接受量和执行成本。按这些维度分别测量,才能判断一项配置变化改善了什么、又引入了哪些成本。
测量脚本的正确性同样影响结果解释。一轮 hybrid 测试曾出现 NaN 接受率和超过 100% 的按位置比例,原因为脚本混淆了计数器的 _created 时间戳与 _total 累计值。修正后完成重跑;该轮异常接受率已从本次分析中剔除,未用于步时计算。异常与重跑记录
后续实验可沿用四个固定提示词,为每个请求同时保存速度、接受计数、完整输出、结束原因和配置摘要,并在隔离其他流量、排除计数器重置后开展重复对照。并发性能应以整组完成时间评估,JSON 可用性需通过完整输出的解析检查,最终配置的长上下文能力则需重新测试,不能直接沿用 9 月 3 日旧配置的结果。
调整后的双机配置完成了文中所述测试。结果支持两个有限结论:所测八路并发的聚合吞吐有所提高;同配置的单流速度随任务的草稿接受情况变化。后续工作应通过执行时间线分解单轮开销,确认元数据处理、GPU 计算与同步等待的占比,再据此确定代码优化的优先级。
资料与复核
数值表与图表均可追溯到随文保存的历史输出。原始会话日期为 2026 年 9 月 3 日至 8 日,日志同时出现 UTC 和美东时间;图 2 沿用日志中的当地时刻。健康检查与容量记录的结论均限定于对应实验配置和观测时段。
- 完整实验结果摘录:含原配置、执行器切换、MTP 关闭、检查点切换、异常采样与最终回测。
- 事实核查与改写说明:逐项列出来源、修正和未验证的边界。
- 四任务基准脚本与单流及并发脚本:提供移除连接信息后的归档副本,用于审阅计时逻辑;发布期间未运行这些脚本。
- NVIDIA DGX Spark 架构说明、容器 GPU 访问故障说明。
- 社区双机部署项目与SGLang 目标模型支持 PR:提供背景与排查线索,状态可能随上游继续变化。